Transformer Nedir? Dikkat Mekanizmasını Deneyerek Öğren
29 Eylül 2026
Bir dil modeline “Türkiye’nin başkenti…” yazdığınızda ekranda “Ankara” belirir. Peki aradaki boşlukta ne olur? Kelimeler bir sözlükten mi çekilir, cümle ezberden mi tamamlanır, yoksa her defasında yeni bir hesap mı yapılır?
Transformer, bu hesabı kurmanın bir yoludur: metni sayısal parçalara dönüştürür, parçalar arasındaki ilişkileri işler ve bağlama uygun bir çıktı üretir. Bu yazıda mekanizmayı adım adım açacağız. Üç küçük deneyde sayıları kendiniz değiştirebilir, en alttaki videoda bütün akışı izleyebilirsiniz.
Bu sayfanın küçük anlaşması: Deneylerdeki parçalar, vektörler ve puanlar öğretim için seçildi. Tarayıcıda gerçek bir dil modeli çalışmıyor. Hesaplar gerçek; modelden ölçülmüş veri oldukları iddiası yok.
01 / Önce kelimeler değil, tokenlar
Bilgisayar metni doğrudan bizim gibi okumaz. Bir tokenizer, metni token denen parçalara ayırır; her parçayı sözlükteki bir kimlikle eşler. Token bazen bir kelime, bazen bir kelimenin parçası, bazen de noktalama işaretidir. “Bir token eşittir bir kelime” kuralı yoktur.
Türkçe, “kitaplarımdan” gibi bir sözcüğe birden fazla ek sığdırabilir. Bu nedenle alt kelime parçaları kullanışlıdır. Ancak tokenizer bir dil bilgisi öğretmeni gibi ek çözümlemesi yapmak zorunda değildir: parçalama biçimi kullanılan algoritmaya ve öğrenilen sözlüğe bağlıdır. Hugging Face’in tokenizer anlatımı, kelime, karakter ve alt kelime yaklaşımlarını karşılaştırır.
Aşağıda önce örneği seçin, sonra bir parçaya dokunun. Aynı metnin önce ayrık kimliklere, ardından sayısal vektörlere dönüştüğünü göreceksiniz.
02 / Bir kimlik, bir vektöre nasıl dönüşür?
Token kimliği, sözlükteki satır numarası gibidir. Kimliği 42 olan bir token, kimliği 21 olanın “iki katı anlamlı” değildir. Model bu kimliği, öğrenilmiş bir embedding tablosundan bir vektör seçmek için kullanır.
Vektörü, birçok özelliği aynı anda taşıyan bir sayı listesi olarak düşünün. Deneyde okunabilir olması için üç sayı gösterdik. Gerçekte boyut sayısı mimariye göre çok daha büyük olabilir; ayrıca her boyuta “hayvanlık”, “duygu” veya “şehir” gibi kesin bir etiket vermek genellikle mümkün değildir.
Başlangıçtaki token vektörü ile katmanlar boyunca güncellenen bağlamsal vektörü ayırmak da önemlidir. “Yüz” kelimesini “yüz lira”, “gülen yüz” ve “denizde yüz” içinde düşünün. Yazım aynı olsa da çevresindeki metin değiştikçe modelin işlediği temsil değişir.
Sıra bilgisi nereden gelir?
“İki yüz” ile “yüz iki” aynı kelimeleri içerir, aynı anlama gelmez. Bu yüzden ilişkiler işlenirken konum bilgisi de gerekir. Özgün Transformer çalışmasında sinüs ve kosinüs tabanlı konum kodları kullanılır. Öğrenilmiş konum vektörleri ve döner konum gömmeleri gibi başka yöntemler de vardır. Bütün Transformer modellerinin aynı konum yöntemini kullandığını varsaymamak gerekir.
03 / Dikkat: Bu parça hangi parçadan ne kadar bilgi alsın?
Şu iki cümleyi karşılaştırın:
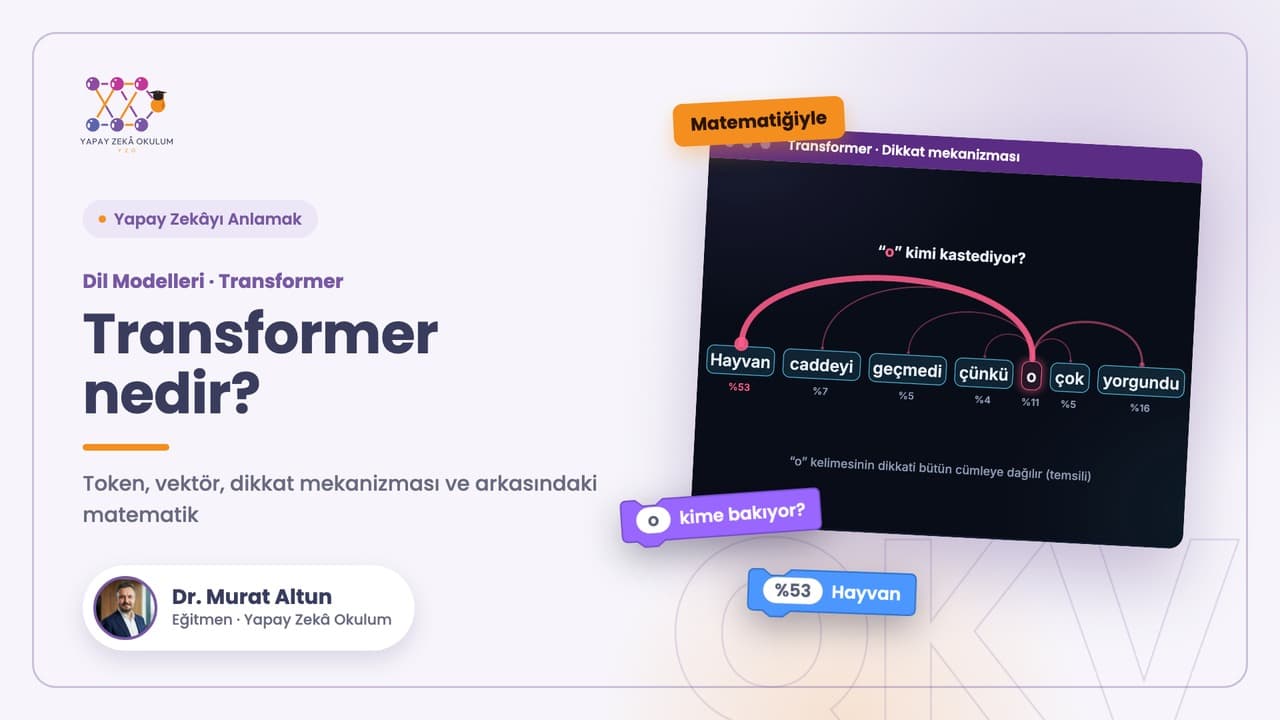
Hayvan caddeyi geçmedi, çünkü o çok yorgundu.
Hayvan caddeyi geçmedi, çünkü o çok genişti.
Birinci cümlede “o” için hayvan, ikinci cümlede cadde daha uygun bir yorumdur. Dikkat mekanizması (attention), bir konumdaki temsili diğer konumlardan gelen bilgilerle günceller. Hangi bilginin ne kadar katkı yapacağını sayısal ağırlıklar belirler.
Bu, insanın dikkatinin birebir modeli değildir. Ağırlıklar da “modelin düşündüğü şeyi eksiksiz okuyan” bir açıklama değildir. Burada işimize yarayan soru daha somut: Bir tokenın yeni vektörüne, hangi tokenların değer vektörleri ne kadar katılıyor?
BAĞLAMIN PEŞİNDEDENEY 02
Tek kelime değişsin. Dikkat yön değiştirsin.
Cümlenin sonunu değiştir; “o” ile kurulan bağı karşılaştır.
Hayvancaddeyigeçmediçünküoçokyorgundu
“o” için en büyük ağırlık: Hayvan
Hayvan
caddeyi
geçmedi
çünkü
o
çok
yorgundu
Bu deneyde iki cümle için önceden seçilmiş puanlara softmax uygulanıyor; çalışan bir dil modeli yok. Bağlamı görselleştiren bu çift yönlü örnekte gelecek kelimeler de görünür. GPT türü bir modelde nedensel maske, bir konumun sonraki tokenlara bakmasını engeller.
ETKİLEŞİMLİ ÖĞRENME
Sorgu, anahtar, değer: Aynı vektörden üç ayrı rol
Dikkat hesabında her tokenın temsili öğrenilmiş dönüşümlerden geçer:
Rol
Kısa adı
Hesaptaki görevi
Sorgu
Q / Query
Hangi anahtarlarla uyum hesaplanacak?
Anahtar
K / Key
Sorguyla karşılaştırılan temsil
Değer
V / Value
Ağırlıklandırılıp yeni temsile taşınan bilgi
Bir kütüphane benzetmesiyle sorgu aradığınız özelliklere, anahtar kitabın aranabilir etiketlerine, değer ise alıp kullandığınız bilgiye benzer. Benzetmenin sınırı şudur: modelde bunlar elle yazılmış etiketler değil, eğitimde öğrenilen matrislerle üretilen sayılardır.
04 / Formülün içine girelim
Dikkat hesabının yaygın biçimi şöyledir:
Attention(Q, K, V) = softmax(QKᵀ / √dₖ)V
Formülü dört harekete ayırabiliriz:
Uyumu hesapla. Bir sorgu vektörüyle bir anahtar vektörünün nokta çarpımını alın. Örneğin [2, 1, 0] · [1, 3, −1] = 2×1 + 1×3 + 0×(−1) = 5. Bu puan hem yön hem büyüklükten etkilenir; tek başına yalnız açı ölçmez.
Ölçekle. Puanı anahtar boyutunun kareköküne bölün. Boyut 64 ise bölen 8 olur. Bu ölçekleme, uygun varsayımlar altında boyutla büyüyen puanların softmax’ı aşırı keskinleştirmesini sınırlamaya yardımcı olur.
Dağılıma dönüştür. Softmax ile izin verilen konumların ağırlıkları pozitif olur ve toplamları 1’e gelir. Maskelenen konumlar hesapta sıfır ağırlık alır.
Bilgiyi birleştir. Her değer vektörünü kendi ağırlığıyla çarpın ve toplayın. Sonuç, ilgili konumun diğer konumlardan topladığı bilgi vektörüdür.
Buradaki matris çarpımları çok sayıda token için birlikte hesaplanabilir. Transformer’ın hesaplama gücünü verimli kullanabilmesinin temel nedenlerinden biri budur. Özgün mimarinin çıkış noktası için Attention Is All You Need makalesine bakabilirsiniz.
Tek dikkat kafası neden yetmesin?
Çok başlı dikkat, farklı öğrenilmiş dönüşümlerle birden fazla dikkat hesabı yapar. Sonuçlar yan yana getirilir ve yeniden dönüştürülür. Böylece aynı girdinin farklı ilişkileri birden fazla temsil üzerinden işlenebilir. Her kafaya baştan “sen özneyi, sen zamiri bul” diye bir görev verilmez; belirli görevleri her modelde aynı kafanın üstlendiği de söylenemez.
05 / Bir dikkat hesabından bütün modele
Bir Transformer bloğu yalnız attention’dan oluşmaz. İleri beslemeli ağlar her konumdaki bilgiyi işler; artık bağlantılar önceki temsilleri yeni sonuçlarla toplar; normalizasyon katmanları hesapların kararlılığına katkı sağlar. Bu bloklar üst üste kullanılır. Ayrıntılı sıralama modele göre değişebilir.
BERT ve GPT aynı mimari ailesinin farklı kullanımlarıdır. BERT türü bir encoder, metindeki bir konumu iki yöndeki bağlamla işler. GPT türü otoregresif decoder ise bir konumdaki tahminde sonraki tokenları görmez. Bunu nedensel dikkat maskesi sağlar. Ayrımın modeller düzeyindeki özeti Hugging Face’in Transformer mimarileri bölümünde bulunabilir.
Bu nedenle “Transformer bütün kelimelere aynı anda bakar” ifadesi tek başına eksik kalır. Eğitimde pek çok konumun hesabı paralel yapılabilir. Otoregresif metin üretiminde ise yeni tokenlar sırayla seçilir. Önceki hesapların bir bölümü önbellekte tutulabilir; her adımda baştan aynı işi yapmak gerekmez.
06 / Sıcaklık bilgiyi değil, seçim dağılımını değiştirir
Bir dil modeli, sıradaki token için sözlükteki adaylara puanlar üretir. Bunlara logit denir. Puanlar softmax ile olasılıklara çevrilir. Örnekleme yapılacaksa sıcaklık, bu dağılımın ne kadar keskin veya yaygın olacağını etkiler.
Düşük sıcaklık en yüksek puanlı adayları öne çıkarır. Yüksek sıcaklık daha düşük puanlı adaylara da alan açar. Ancak modelin öğrendiği bilgiyi artırmaz ve yanlış bir cevabı kendiliğinden düzeltmez. “Daha yaratıcı” sözü, daha geniş bir dağılımdan örneklemenin olası sonucu için kullanılan bir kısaltmadır; bir kalite garantisi değildir.
SONRAKİ TOKENDENEY 03
Dağılımın sıcaklığıyla oyna.
Aynı puanlar, farklı olasılıklar. Kaydır ve farkı gör.
METİN
Türkiye’nin başkenti ▍
Keskin dağılımDaha yaygın dağılım
Ankara
İstanbul
İzmir
Bursa
Puan farkları olasılık dağılımında görünür kalıyor.
pᵢ = exp(zᵢ / T) / Σⱼ exp(zⱼ / T)
Puanlar temsili: [3.2; 2.1; 1.3; 0.4]. Yalnız bu dört aday arasında normalize ediliyor; gerçek model çıktısı değil. Sıcaklık bilgiyi veya doğruluğu artırmaz. Etkisi olasılıktan örnekleme yapıldığında ortaya çıkar; en yüksek puanlı adayı seçen yöntemde sıralama değişmez.
ETKİLEŞİMLİ ÖĞRENME
Deneyde Ankara’nın sırası hiç değişmedi. Değişen şey ona ve diğer adaylara ayrılan olasılık oldu. Her defasında en yüksek puanlı adayı seçerseniz sıcaklık, bu örnekte seçimi değiştirmez. Rastgele örneklemede ise düşük puanlı bir adayın gelme şansı değişir. Üretim stratejileri belgesi bu seçim yollarını açıklar.
07 / Peki bütün bu sayıları kim öğretiyor?
Bir otoregresif dil modelinin ön eğitiminde yaygın görev, metnin önceki kısmından sonraki tokenı tahmin etmektir. Doğru tokena verilen olasılık düşükse kayıp büyür. Geri yayılım, parametrelerin kayba etkisini hesaplar; optimizasyon adımı parametreleri günceller.
Bu süreç “her cümleyi bir kutuya koyup saklamak” kadar basit değildir. Model, verideki düzenlilikleri çok sayıda parametrede öğrenir; bazı içerikleri ezberleyebilmesi de mümkündür. Eğitim verisinin niteliği, öğrenme yöntemi ve sonraki uyarlamalar davranışını etkiler. Akıcı bir cümle kurması, o cümlenin doğru olduğunu kanıtlamaz.
Kendinizi üç soruyla sınayın
Bir tokenın kimliği büyükse anlamı da daha mı büyüktür? Hayır. Kimlik bir indeks; anlamla ilgili hesap öğrenilmiş temsiller üzerindedir.
Dikkat ağırlığı %70 ise modelin cevabı %70 doğru mudur? Hayır. Dikkat ağırlığı, bilgi karışımındaki paydır; doğruluk olasılığı değildir.
Sıcaklığı artırınca modele yeni bilgi eklenir mi? Hayır. Parametreler aynı kalır, örnekleme dağılımı değişir.
Sıkça Sorulan Sorular
Transformer ile ChatGPT aynı şey mi?
Hayır. Transformer bir sinir ağı mimarisi ailesidir. ChatGPT bir uygulamadır; dil modeli, araçlar ve ürün davranışları gibi birden fazla unsur içerir. Bir mimariyi öğrenmek, uygulamanın her ayrıntısını bildiğimiz anlamına gelmez.
Attention, modelin akıl yürütmesini gösterir mi?
Dikkat ağırlıkları belirli bir hesaplama katmanındaki bilgi akışının bir bölümünü gösterir. Tek bir kafa veya ağırlık haritası, bütün modelin gerekçesini açıklamaya yeterli değildir. Yüksek ağırlığı doğrudan neden, niyet veya doğruluk olarak yorumlamamak gerekir.
Bu sayfadaki deneyler gerçek yapay zekâ mı çalıştırıyor?
Hayır. JavaScript ile önceden belirlenmiş küçük örnekler üzerinde hesap yapılıyor. Amaç, token kimliği ile vektörün farkını, dikkat ağırlıklarının toplamını ve sıcaklığın softmax’a etkisini elle değiştirerek görmek.
Videodaki sayılarla deneyler neden aynı değil?
Videoda hem temsili örnekler hem de adı belirtilen modellerden alınan ölçümler var. Bu sayfadaki deneyler ise mekanizmayı kolay karşılaştırmak için özellikle sadeleştirildi ve tamamı temsili olarak işaretlendi.
Şimdi bütün yolculuğu videoda izleyin
9 dakika 4 saniyede: token → vektör → konum → dikkat → Transformer bloğu → sonraki token. Dr. Murat Altun’un anlatımıyla hazırlanan videoda nokta çarpımını, softmax’ı ve gerçek model örneklerini animasyonlarla takip edebilirsiniz. Seslendirmede Dr. Murat Altun’un yapay zekâyla üretilen klon sesi kullanılmıştır.
Öğretmenseniz önce ikinci deneyi sınıfta açıp “o kimi gösteriyor?” sorusunu tartıştırabilir, ardından videonun dikkat mekanizması bölümüne geçebilirsiniz. Uygulamalı öğrenmeye devam etmek için YZO eğitimlerini inceleyebilirsiniz.
KELİMEDEN VEKTÖREDENEY 01
Bir kelimenin içini aç.
Metin önce parçalara, sonra sayılara dönüşür.
Bir parçaya dokun; sayı yolculuğunu izle.
SEÇİLEN TOKEN“Kitap”
SÖZLÜK KİMLİĞİ42
VEKTÖR[0.8, -0.2, 0.6]
Bölünmeler, kimlikler ve üç boyutlu vektörler temsili. Gerçek tokenizer farklı parçalar üretebilir; token sınırı her zaman Türkçedeki ek sınırı değildir. ▁ işareti boşluğu görünür kılar.
ETKİLEŞİMLİ ÖĞRENME
Transformer Nedir? Dikkat Mekanizmasını Deneyerek Öğren